模型聚合路由 · 探索全网尖端基座
发现、评估并调用适合您业务的最佳模型,统一标准接口封装,支持即开即用与动态切换。
秒云Tokens管家全链路生产架构 · 动态推演
Token SLA:接入只是开始,稳定才算交付
智能分池路由、吞吐保障、零抖动流式输出——秒云把稳定交付到生产环境的每一次调用。
秒云Tokens管家实时指标监控
● PROD-GATEWAY-SH01采集粒度: 1s
秒云Tokens管家:全链路管控企业AI Token成本与效能
打破传统 API 调用“分散管理、效果难控、成本失衡”的核心痛点,为您提供一站式调用与精细化 Token 管理服务。
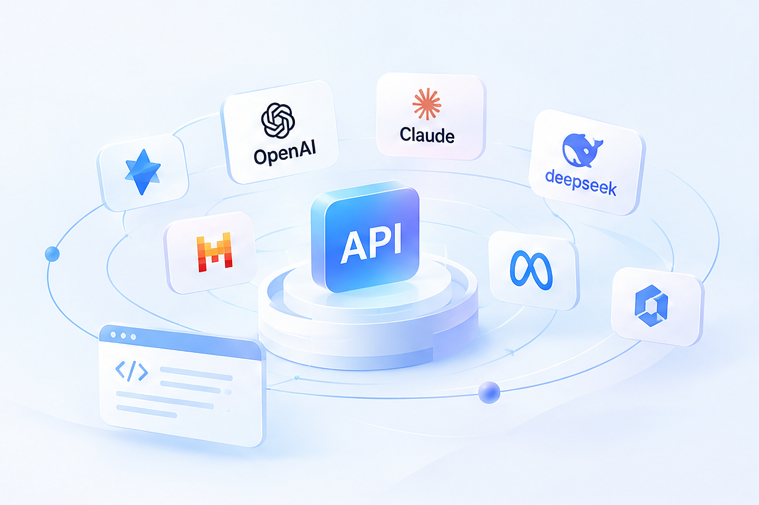
一个 API,一键调用所有主流模型
“一次接入,统一鉴权”。开发者只需获取一个 LLM API Key,无需修改原有业务代码架构,即可一键调用全网优质大模型。彻底解决多模型混用调试繁杂、厂商切换成本高昂的行业痛点。
全链路 Token 监控与可视化
构建全链路可观测体系,依托响应速度、成功率、Token 吞吐等多维度评测指标,实现 Token 消耗的实时监测与全生命周期追溯。直观查看成本结构,精准定位“高消耗、低产出”的异常调用。
精细化管控与 Token 成本优化
支持按部门、项目、人员等多维度分配 Token 配额并推送消耗预警。通过智能匹配模型、前缀缓存复用等方式大幅降低无效消耗,助力企业精准选型,做企业 AI 支出的“智能守门人”。
调用效果评测与智能告警
支持自定义评测指标,通过交互式报表直观对比不同模型参数下的调用表现,支撑科学决策。基于异常检测算法,及时推送服务质量波动提醒并提供针对性调优建议,降低整体运维成本。
像调用 OpenAI 一样,调用所有模型
同一套 SDK、同一份代码,替换 BaseURL 即可调度秒云Tokens管家聚合的全网大模型
# 使用标准 OpenAI 兼容 SDK,仅需配置秒云Tokens管家统一 BaseURL 与 API Key 即可调用全网大模型
from openai import OpenAI

client = OpenAI(
    api_key="my-sk-xxxxxxxxxxxxxxxxxxxxxxxx",  # 秒云Tokens管家颁发的统一企业密钥
    base_url="https://maas.miaoyun.net.cn/v1"   # 秒云Tokens管家分发路由集群
)

stream = client.chat.completions.create(
    model="qwen3.8-max",  # 支持一键切换 kimi-k3 / glm-5.3 / deepseek-v4-pro 等
    messages=[
        {"role": "system", "content": "You are an enterprise AI architect."},
        {"role": "user", "content": "请评测当前秒云异构算力网关在高并发大模型场景下的吞吐与前缀缓存收益"}
    ],
    stream=True
)

for chunk in stream:
print(chunk.choices[0].delta.content or "", end="", flush=True)兼容 OpenAI 常用接口
全面兼容 OpenAI API 协议,替换 Base URL 即可无缝接入,业务代码零改动。
统一 API 接入
统一 API 标准与企业级密钥,一个 Key 调度全网模型,降低运维成本。
开发者友好
文档与示例齐全,多语言 SDK 即开即用,加速集成上线。
兼容主流 AI 编程与 Agent 生产力工具
一个 API Key,即刻无缝接入各类 IDE 插件、开源智能体框架与低代码平台